THE AI-NATIVE SDLC PLAYBOOK

คู่มือออกแบบวงจรพัฒนาซอฟต์แวร์
สำหรับยุค AI Agent

ฉบับภาษาไทย · เรียบเรียงจาก Claude Academy

Thai Edition byPratya SureeSoftware CraftsmanCodejadee.com
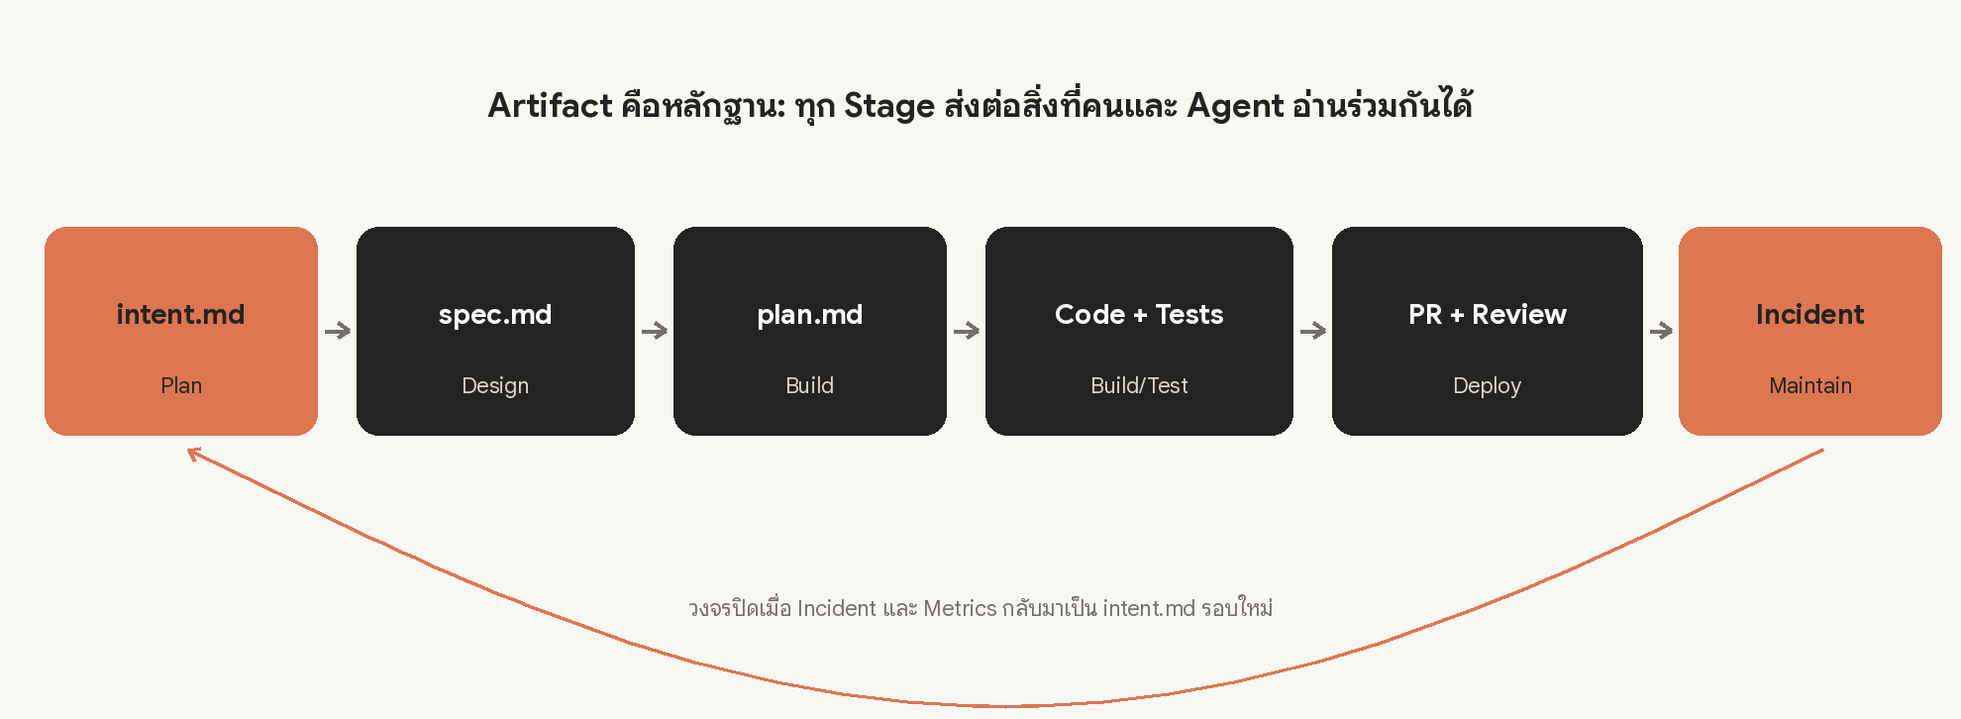
Artifact Chain ของ AI-Native SDLC
Artifact Chain ที่เชื่อมทั้งวงจร

เกี่ยวกับหนังสือฉบับนี้

หนังสือเล่มนี้เรียบเรียงจากหลักสูตร The AI-Native SDLC Playbook ของ Claude Academy ทั้ง 14 บท จุดประสงค์คือถ่ายทอดแนวคิดให้ผู้อ่านภาษาไทยเข้าใจภาพรวมและนำไปปรับใช้กับกระบวนการพัฒนาซอฟต์แวร์ได้ง่ายขึ้น เนื้อหาเป็นการเรียบเรียงและถอดความ ไม่ใช่คำแปลอย่างเป็นทางการของ Anthropic

คำศัพท์เทคนิค เช่น AI Agent, CI/CD, PR, Hook, Skill, MCP, Eval, Worktree และ Artifact คงรูปแบบภาษาอังกฤษไว้ตามการใช้งานจริงในวงการ ส่วนชื่อไฟล์และคำสั่งต่าง ๆ คงรูปแบบเดิมเพื่อให้นำไปใช้งานต่อได้

เส้นทางการอ่าน

1 · Planจับเจตนาเป็น intent.md
2 · Designเปลี่ยน Intent เป็น spec.md ภายใต้ Policy
3 · BuildPlan Mode, CLAUDE.md, Skills, Subagents
4 · TestFeedback Loop และ Continuous Evals
5 · DeployPR Review, Hooks และ CI/CD
6 · MaintainMetrics ปิดลูปกลับสู่ Intent

แหล่งต้นฉบับหลัก: Claude Academy — The AI-Native SDLC Playbook

บทนำLESSON 01

เมื่อ Code ไม่ใช่คอขวดอีกต่อไป

ทำความเข้าใจว่าเหตุใดการเร่งความเร็วเฉพาะการเขียนโค้ดจึงยังไม่ทำให้องค์กรส่งมอบซอฟต์แวร์ได้เร็วเท่าที่ควร

SDLC แบบดั้งเดิมถูกสร้างขึ้นในยุคที่การลงมือเขียนและแก้โค้ดกินเวลามากที่สุด วงจรจึงแบ่งออกเป็นช่วงชัดเจน ตั้งแต่ Plan Design Build Test Deploy ไปจนถึง Maintain แต่ละช่วงมีเจ้าของงานคนละบทบาทและส่งต่องานผ่านเอกสาร Ticket การ Review และการอนุมัติ

เมื่อ AI Agent เขียนโค้ดได้เร็วขึ้นหลายเท่า สมมติฐานเดิมเริ่มใช้ไม่ได้ ขั้น Build หดสั้นลง แต่ Requirements การ Review การทดสอบ การอนุมัติ และการ Release ยังเคลื่อนด้วยความเร็วของคน ผลคือเวลาที่ประหยัดได้จากการเขียนโค้ดอาจถูกกินกลับไปในคิวงานรอบข้าง
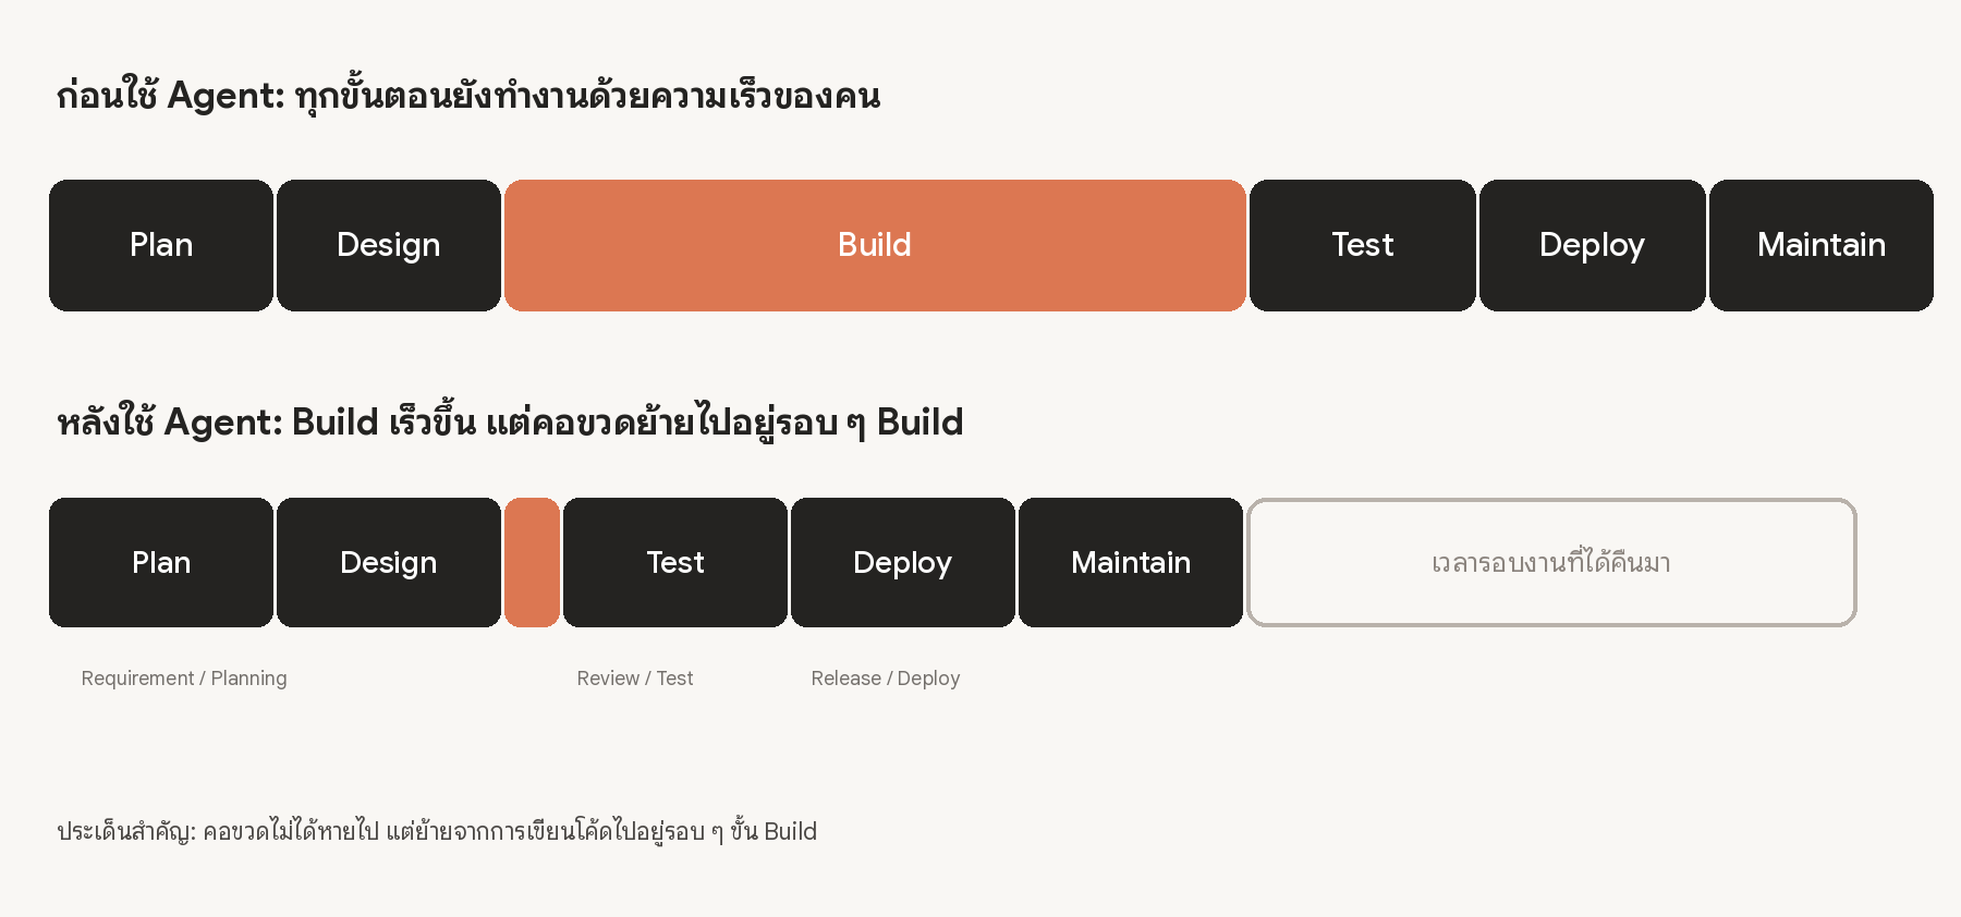
ภาพ 1 · คอขวดย้ายตำแหน่งเมื่อ Build เร็วขึ้น · ดัดแปลงจาก Claude Academy

AI-Native SDLC คืออะไร

AI-Native SDLC ไม่ได้หมายถึงการใส่ Chatbot เพิ่มในทุกทีม แต่คือการออกแบบวงจรใหม่ให้ AI มีบทบาทในแต่ละ Stage ขณะที่มนุษย์ยังเป็นผู้ตัดสินใจในเรื่องที่ต้องใช้วิจารณญาณ งานส่งต่อกันด้วย Artifact ที่อ่านได้ทั้งคนและ Agent และเมื่อ Artifact หนึ่งผ่าน Gate แล้ว สามารถ Trigger ขั้นถัดไปได้โดยอัตโนมัติ
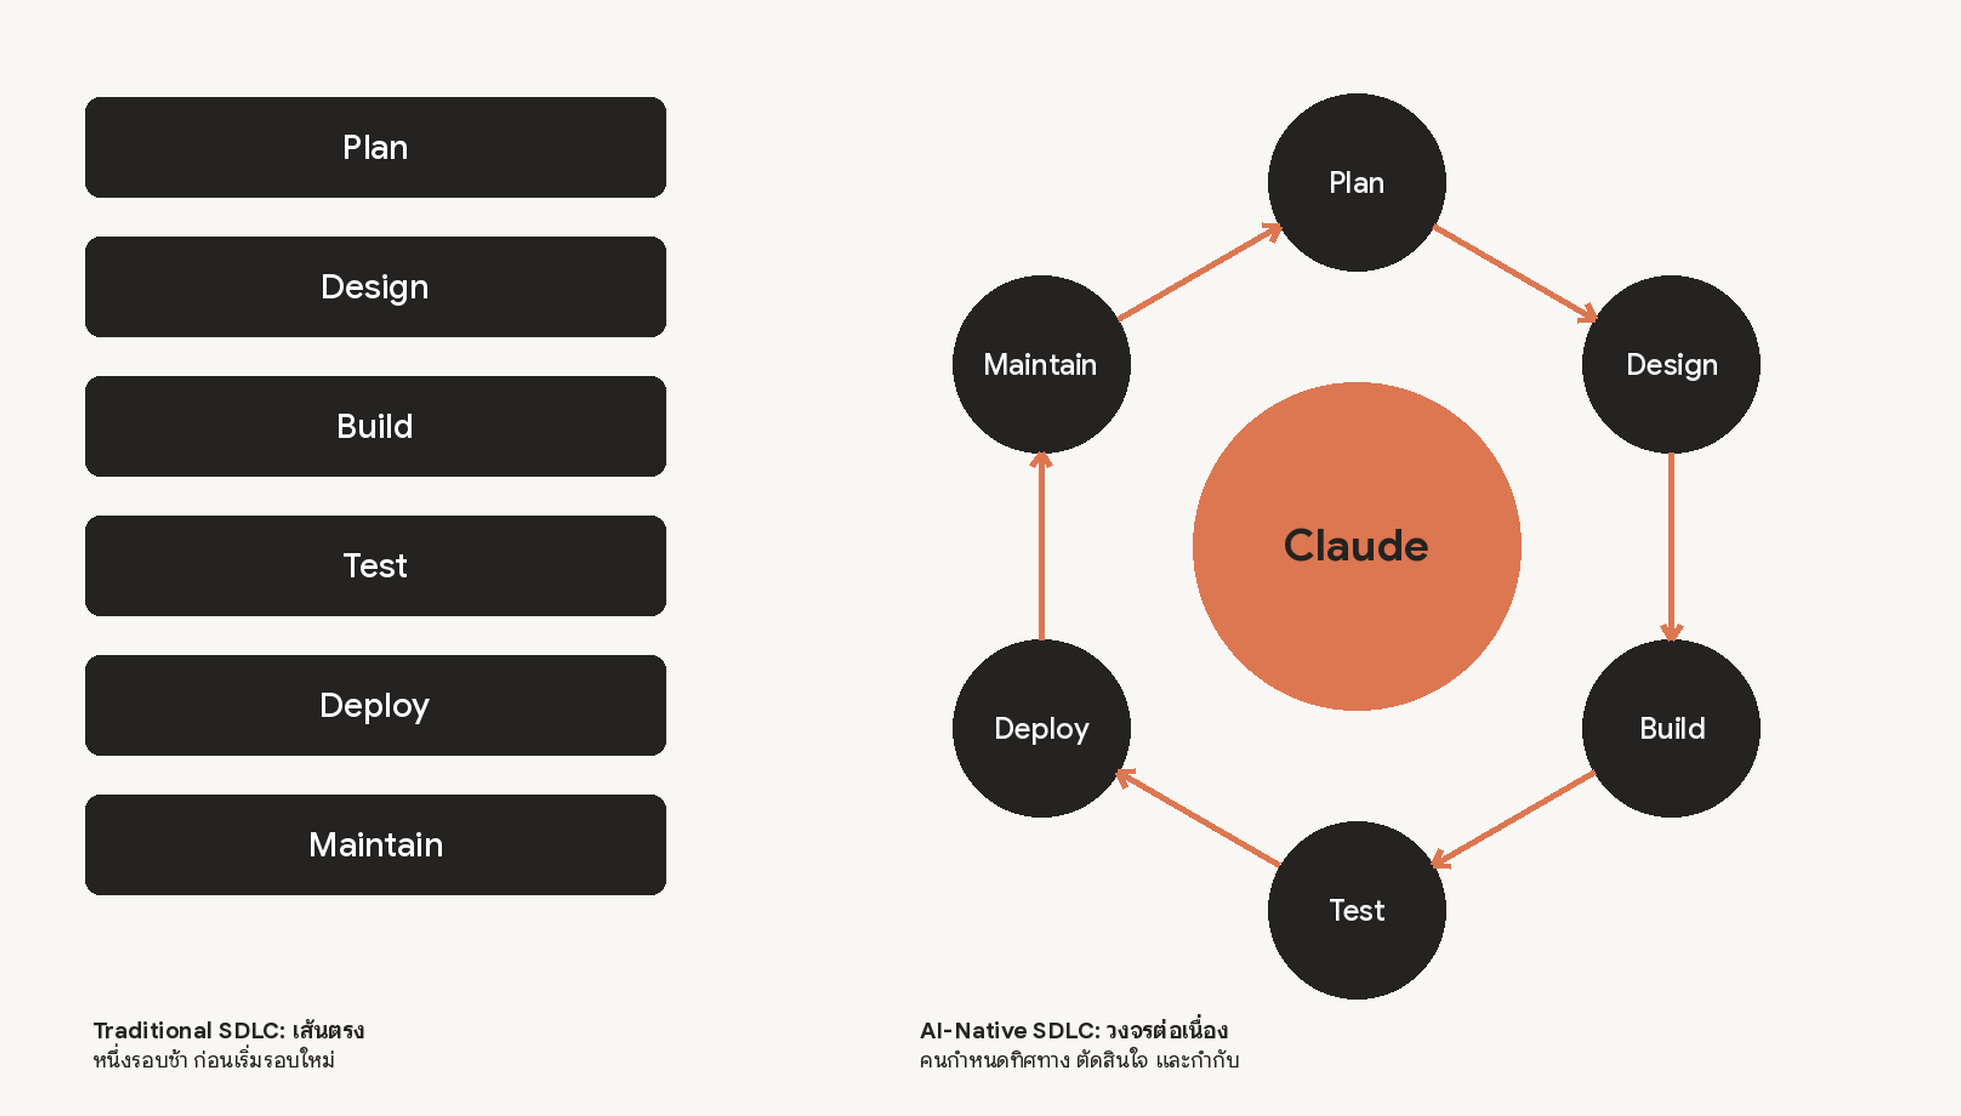
ภาพ 2 · จาก Linear SDLC สู่ Continuous Loop · ดัดแปลงจาก Claude Academy

การเปลี่ยนแปลงในแต่ละ Stage

Stage Traditional AI-Native
Plan รวบรวม Requirement ผ่าน Workshop และ Sign-off Claude สังเคราะห์ปัญหาเป็น intent.md
Design Requirement กับ Design แยกทีมและส่งต่อกัน Agent สร้าง spec.md ภายใต้ Policy ที่เข้ารหัสเป็น Skills
Build คนเขียน Code/Test และทำเอกสารภายหลัง AI สร้าง Code/Test โดยมี CLAUDE.md และ Skills เป็นความรู้ประจำงาน
Test QA เป็น Gate หลังงาน Build Feedback Loop และ Eval ทำงานต่อเนื่องระหว่างพัฒนา
Deploy คน Review รายบรรทัดและอนุมัติเป็นรอบ Agent Review หลายชั้น ส่วน Human Review โฟกัส Intent Risk และ Gate สำคัญ
Maintain คนเฝ้าระบบและเริ่มงานแก้เอง Metric หรือ Incident Trigger Agent ให้สร้าง intent.md รอบใหม่

สิ่งที่เชื่อมทั้งวงจร: Artifact

ทุก Stage จบด้วยหลักฐานที่ Commit ลง Version Control หรือบันทึกในระบบที่องค์กรยอมรับ เช่น intent.md, spec.md, plan.md, Code Diff, Tests, PR Review และ Incident Record หลักฐานเหล่านี้ทำหน้าที่สองอย่างพร้อมกัน คือเป็น Input ของขั้นถัดไปและเป็น Audit Trail ว่าใครขออะไร Agent ทำอะไร และใครอนุมัติ
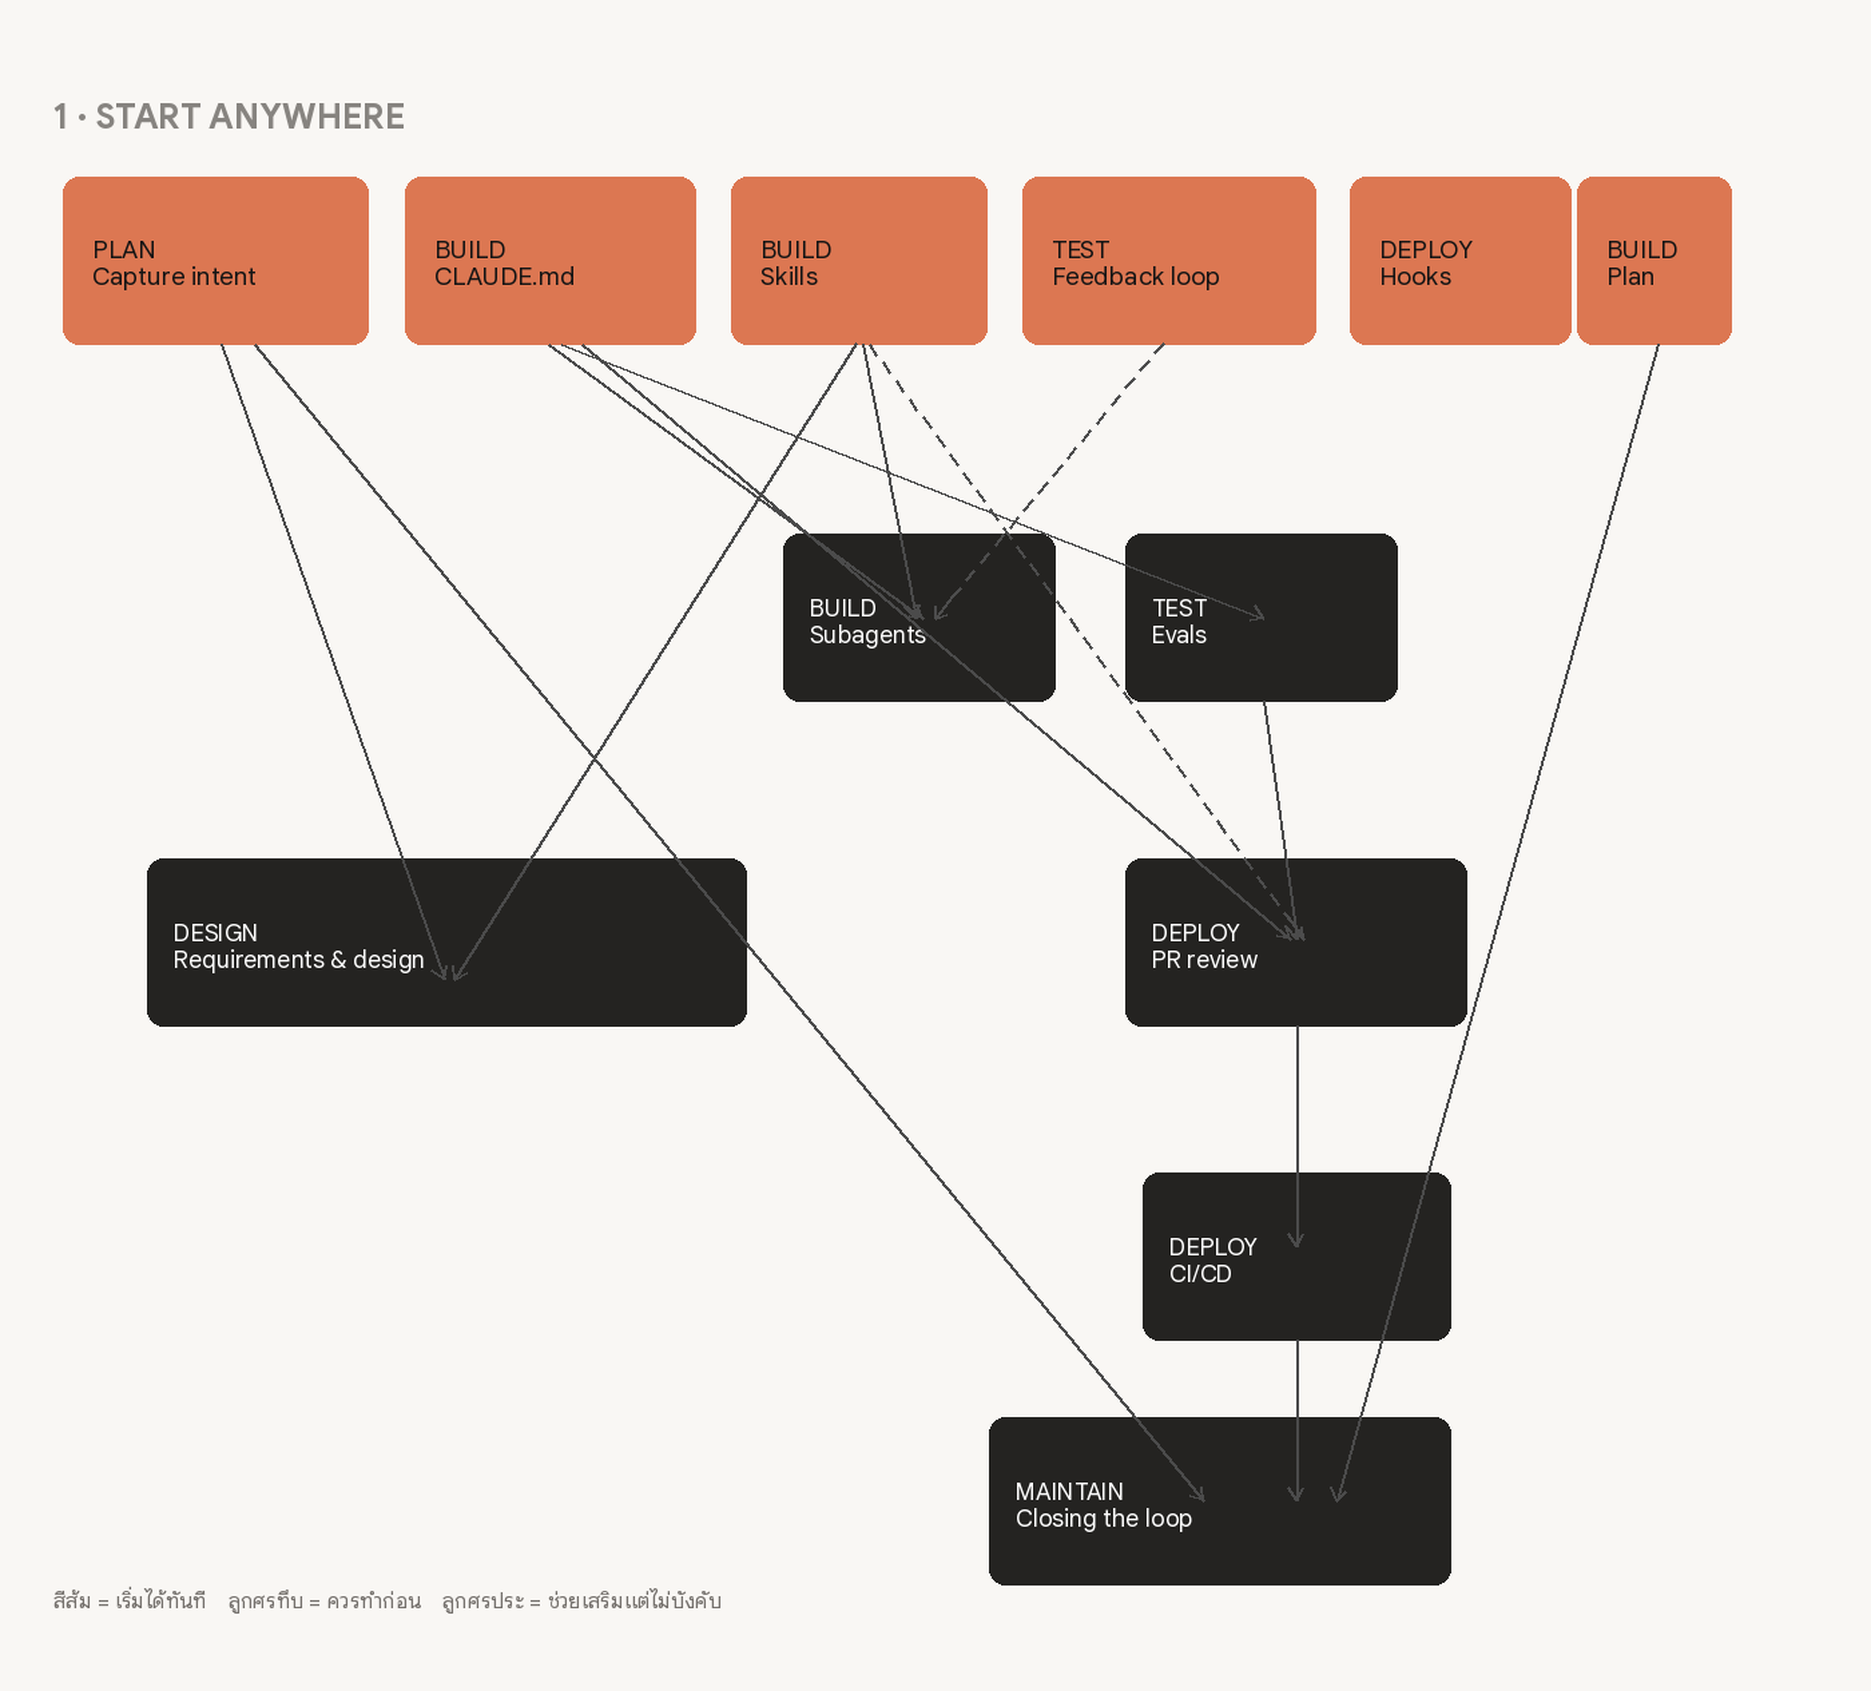
ภาพ 3 · Dependency ของแต่ละ Play · ดัดแปลงจาก Claude Academy

แหล่งอ้างอิงบทนี้: Introduction

Stage 1 · PlanLESSON 02

Capture as intent.md

เปลี่ยนแนวคิด Ticket หรือ Incident ให้กลายเป็น Proto-Spec ที่คนและ Agent

จุดเริ่มต้นของงานไม่จำเป็นต้องเป็น Requirement ที่สมบูรณ์ แนวคิดอาจมาจากผู้ใช้งาน Ticket หรือ Alert จาก Production สิ่งสำคัญคือทำให้เจตนาถูกจับไว้ในรูปแบบที่อ่านง่าย มี Version และส่งต่อได้ จึงเกิดไฟล์ intent.md ซึ่งทำหน้าที่เป็น Proto-Spec ของงาน

Traditional SDLC AI-Native SDLC
ไอเดียผ่าน Backlog User Story Estimation และ Refinement หลายชั้น ความหมายเดิมอาจเจือจางระหว่างการส่งต่อ เจ้าของปัญหาคุยกับ Claude โดยตรง แล้วบันทึกสิ่งที่ต้องการ เหตุผล ขอบเขต ข้อจำกัด และคำถามค้างไว้ใน intent.md

เริ่มต้นอย่างไร

  • กำหนด Template มาตรฐานของ intent.md

  • เตรียมพื้นที่ Version Control เช่นโฟลเดอร์ intent/ ใน Repository

  • เปิดทางให้คนที่ไม่ถนัด Git สามารถให้ Claude Commit เอกสารผ่าน Connector ได้

  • ระบุ Product Owner ที่คอย Review และตัดสินใจ Accept หรือ Reject

Workflow

  1. เจ้าของแนวคิดอธิบายปัญหาด้วยภาษาของตนเอง

  2. Claude ช่วยถามต่อเรื่อง Scope ผู้ใช้ Constraints และ Success Criteria

  3. สร้าง intent.md ตาม Template ขององค์กร

  4. เจ้าของแนวคิดแก้สิ่งที่ Agent เข้าใจคลาดเคลื่อน

  5. Commit เข้าพื้นที่กลางเพื่อให้ Product Owner รับช่วงต่อ

ตัวอย่างโครงสร้าง intent.md

โครงสร้างตัวอย่างที่ดัดแปลงจากต้นฉบับ

# Intent: claim-status-self-service
Author: Product Operations
Status: draft
## Problem
ลูกค้าต้องโทรถามสถานะเคสซ้ำ ๆ ทำให้ทีม Support ใช้เวลามาก
## Proposed outcome
ลูกค้าดูสถานะ ขั้นตอนถัดไป และวันที่คาดหมายจาก Portal ได้
## Affected users and systems
Customer Portal, Support Team, Core API
## Constraints
ห้ามเพิ่มข้อมูลส่วนบุคคลใหม่ใน Session
## Open questions
Partner ภายนอกต้องเห็นสถานะนี้ด้วยหรือไม่

Governance

หลักฐานคือ intent.md ที่ Commit แล้ว Git เก็บผู้เขียน เวลา และ Revision History ส่วนการ Accept หรือ Reject ของ Product Owner ถูกบันทึกผ่าน Merge หรือ Review Status ทำให้การตัดสินใจตั้งแต่ต้นมีร่องรอยตรวจสอบย้อนหลังได้

วัดผลอย่างไร

Leading indicator เวลาตั้งแต่เริ่มสนทนาจน intent.md ถูก Commit ซึ่งควรลดจากรอบ Elicitation หลายวันหรือหลายสัปดาห์ให้เหลือระดับชั่วโมง
Lagging indicator สัดส่วน intent.md ที่ถูก Accept เข้าสู่ Design และจำนวนครั้งที่ intent.md ต้องแก้หลัง spec.md เริ่มถูกสร้างแล้ว

แหล่งอ้างอิงบทนี้: Capture as intent.md

Stage 2 · DesignLESSON 03

Requirements and design

เปลี่ยน intent.md เป็น spec.md โดยให้ Policy ขององค์กรทำงานเป็น Constraint

เมื่อ Product Owner อนุมัติ intent.md Agent จะใช้เอกสารนั้นสร้าง Requirements และ Design Spec โดยอ่าน Skills ขององค์กร เช่น Brand Security Compliance และ UX เป็นข้อกำกับ เป้าหมายไม่ใช่ให้ Product Owner นั่งเขียน Spec เอง แต่ให้ Product Owner Review ว่า Spec แก้ปัญหาตาม Intent หรือไม่ และมีประเด็นเสี่ยงใดต้องตัดสินใจก่อนส่งให้ทีมพัฒนา

Traditional SDLC AI-Native SDLC
Analyst เขียน Requirement แล้ว Designer แปลงต่ออีกทอด การส่งต่องานช่วยแยกความรับผิดชอบ แต่ช้าและมีโอกาสเสียบริบท Requirements และ Design ถูกทำใน Working Session เดียวกับ Agent โดยมี Skills บังคับกรอบ และ Agent ต้อง Flag จุดขัดแย้งหรือสิ่งที่ยังตอบไม่ได้

Workflow

  1. เปิด Session พร้อม Skills ที่เกี่ยวข้องแล้วแนบ intent.md

  2. สั่งให้ Agent สร้าง spec.md โดยต้องอ้าง Constraints และ Flag ความกังวล

  3. Product Owner Review ว่า Spec ตอบ Problem และ Proposed Outcome จริงหรือไม่

  4. จัดการ Flagged Concern กับเจ้าของ Policy ก่อนส่งให้ Engineering

  5. Commit spec.md ไว้ข้าง intent.md เพื่อเก็บสิ่งที่ขอและสิ่งที่ตัดสินใจ

  6. Human เป็นผู้ตัดสินใจขั้นสุดท้ายว่าจะส่งต่อไป Build หรือไม่

Prompt ตัวอย่าง

Prompt ที่เรียบเรียงจากแนวทางในบท

Governance

ข้อได้เปรียบคือ Policy Conflict ถูกพบระหว่างเขียน Spec แทนที่จะไปเจอหลายสัปดาห์ให้หลัง Version ของ Skills Prompt และ Spec สามารถเก็บใน Version Control ส่วน Flagged Concern ต้องย้อนกลับไปยัง Policy Owner ที่รับผิดชอบจริง

วัดผลอย่างไร

Leading indicator เวลาระหว่าง Commit ของ intent.md และ spec.md สำหรับ Change เดียวกัน
Lagging indicator จำนวนการแก้ spec.md หลัง Build เริ่มแล้ว หากสูงแปลว่า Design Gate ยังจับปัญหาได้ไม่ดีพอ

แหล่งอ้างอิงบทนี้: Requirements and design

Stage นี้มี 4 Play ที่ทำงานร่วมกัน ได้แก่ Plan Mode เพื่อทำแผนก่อนแก้โค้ด CLAUDE.md เพื่อเก็บความรู้ประจำ Repository Skills เพื่อฝังมาตรฐานองค์กร และ Parallel Sessions/Subagents เพื่อเพิ่มความขนานโดยยังรักษาการควบคุม

Stage 3 · BuildLESSON 04

Claude Code Plan Mode

ก่อนแก้โค้ดให้ทำแผนที่อีกคนหนึ่งสามารถอ่านแล้วนำไป Implement ต่อได้

Traditional SDLC AI-Native SDLC
Engineer อ่าน Design แล้วเริ่มเขียนโค้ด วิธีทำส่วนใหญ่อยู่ในหัว Reviewer เห็นครั้งแรกตอน Diff เสร็จแล้ว Session เริ่มใน Plan Mode Agent อ่าน Codebase ได้แต่ยังไม่แก้ไฟล์ แผนถูก Review ก่อนลงมือและ Commit เป็น plan.md

Workflow

  1. เปิด Claude Code ใน Plan Mode

  2. ส่ง intent.md และ spec.md ให้ Agent พร้อมขอรายชื่อไฟล์ ลำดับงาน และ Tests ที่จะพิสูจน์ผล

  3. ถามย้อนถึงสิ่งที่อาจพัง จุดที่เสี่ยงที่สุด และทางเลือกที่ Agent ไม่เลือก

  4. ปรับแผนจน Engineer คนอื่นอ่านแล้ว Implement ต่อได้โดยไม่ต้องอ่านบทสนทนา

  5. Commit plan.md และค่อย Accept ให้ Agent ลงมือ

  6. หาก Implementation เบี่ยงจาก Plan ให้แก้ plan.md ใน Commit เดียวกัน

ตัวอย่าง plan.md

โครงสร้างตัวอย่างที่ดัดแปลงจากต้นฉบับ

# Plan: status-self-service
## Files that change
ui/src/features/status-panel.ts
api/routes/status.cs
tests/status-endpoint-tests.cs
## Order of work
1. เพิ่ม endpoint ภายใต้ auth เดิม
2. เพิ่ม UI panel ที่เรียก endpoint
3. เชื่อมเข้า navigation
## Risks
Core API มี rate limit จึงต้องมี cache
## Proof
Unit/Integration tests ผ่าน และ screenshot ตรงกับ mock ที่อนุมัติ

Auto Mode และความเป็นอิสระของ Agent

เมื่อ CLAUDE.md Skills Hooks และ Feedback Loop แข็งแรงขึ้น งาน Routine สามารถใช้ Auto Mode ได้ หลัง Engineer ตรวจและอนุมัติ Plan แล้ว Agent ลงมือแก้ต่อเนื่องโดยไม่ต้องขออนุมัติทุก Edit จุดโฟกัสของคนจึงขยับจากการเฝ้าทุก Action ไปสู่การ Review Artifact หลัง Session ที่ยาวขึ้น

Legacy System และ Source of Truth

องค์กรจำนวนมากมี Jira ServiceNow Figma หรือ Requirements Tool อยู่แล้ว Playbook ไม่ได้บอกให้รื้อทิ้ง แต่ต้องกำหนดว่า Artifact แต่ละชนิดมี Source of Truth ที่ใด Repo อาจเป็นตัวจริงและ Legacy System เก็บ Link หรือกลับกัน Legacy System เป็นตัวจริงแล้ว Markdown เป็น Working Copy ที่ Agent อ่านและเขียนกลับผ่าน MCP อย่างน้อยที่สุดควรผูก Record ID กับ Commit SHA ให้ตามรอยกันได้

วัดผลอย่างไร

Leading indicator สัดส่วนงานที่ Merge ได้ตั้งแต่ Implementation Pass แรก และเวลาจาก Plan Approved ถึง PR Merge
Lagging indicator จำนวนรอบ Rework ต่อ Change และสัดส่วน Diff ที่ Merge แล้วยังตรงกับ plan.md

แหล่งอ้างอิงบทนี้: Claude Code plan mode as the default starting point

Stage 3 · BuildLESSON 05

The CLAUDE.md

ทำให้ความรู้ที่เคยอยู่ในหัวคนหรือ Wiki กลายเป็น Context ที่ Agent อ่านทุกครั้งเมื่อเริ่ม

CLAUDE.md เปรียบเหมือนคู่มือวันแรกของ Developer ใหม่ แต่เขียนให้ Agent ใช้โดยตรง เนื้อหาที่เหมาะคือ Commands สำคัญ Convention Architecture และข้อผิดพลาดที่ทีมเห็น Agent ทำซ้ำ ๆ จุดสำคัญคือไฟล์นี้ต้องสั้น สดใหม่ และอยู่ใน Git เพื่อให้ทุกคนใช้เวอร์ชันเดียวกัน

วิธีเริ่ม

  1. รัน /init เพื่อให้ Claude สร้างร่างจาก Repository

  2. ตัดให้เหลือเฉพาะสิ่งที่ Developer ใหม่ต้องรู้วันแรก

  3. เก็บไฟล์ไว้ที่ Repo Root และ Review การแก้เหมือน Code

  4. ใช้กฎง่าย ๆ ว่าเมื่อ Claude ทำพลาดเรื่องเดิมสองครั้ง ให้เพิ่ม Correction ลง CLAUDE.md

  5. พยายามให้สั้นประมาณหนึ่งหน้า เพราะทุก Session ต้องอ่านทั้งหมด

ตัวอย่าง CLAUDE.md

ตัวอย่างดัดแปลงให้เข้ากับ .NET

# Payment Service
## Commands
- Build: dotnet build
- Test: dotnet test
- Lint: dotnet format --verify-no-changes
## Conventions
- เก็บเวลาเป็น UTC
- Endpoint ใหม่ต้องมี Integration Test
- ห้ามแก้ Generated Code โดยตรง
## Architecture
- Api/ รับ HTTP
- Application/ เก็บ Use Case
- Domain/ ไม่อ้าง Infrastructure
## Things Claude gets wrong
- ห้ามอัปเกรด Package Version เอง
- โฟลเดอร์ legacy/ ห้ามเพิ่ม Feature ใหม่

Governance และ Metrics

เพราะไฟล์อยู่ใน Git การเปลี่ยนแปลงจึง Review ได้เหมือน Code และสามารถย้อนดูได้ว่าเมื่อใดทีมเพิ่มกฎใหม่ หลักวัดผลที่มีประโยชน์คือจำนวนข้อผิดพลาดซ้ำที่ลดลงและเวลาที่ใช้แก้ Correction ให้กลายเป็น Context กลางของทีม

แหล่งอ้างอิงบทนี้: The CLAUDE.md

Stage 3 · BuildLESSON 06

Skills as institutional knowledge

ทำให้ Policy และมาตรฐานที่ต้องใช้สม่ำเสมอกลายเป็น Instructions ที่ Version

Skills เหมาะกับความรู้ระดับองค์กรที่ต้องถูกใช้ซ้ำอย่างสม่ำเสมอ เช่น Security Standard API Convention หรือ Brand Rule ต่างจาก CLAUDE.md ที่เน้นความรู้ประจำ Repository และต่างจาก Prompt เฉพาะกิจที่มีอายุสั้นกว่า

Workflow

  1. เลือก Policy ที่ปัจจุบันบังคับใช้ไม่สม่ำเสมอ

  2. สร้างโฟลเดอร์ Skill ที่มี SKILL.md โดย Frontmatter บอกว่าควร Trigger เมื่อใด และ Body บอกว่าต้องทำอะไร

  3. วางไว้ที่ .claude/skills/<name>/ หรือแจกระดับองค์กรผ่าน Plugin

  4. ทดสอบหลายรูปแบบคำสั่งเพื่อยืนยันว่า Skill Trigger จริง

  5. เมื่อ Policy เปลี่ยน ให้ Policy Owner Review Skill เวอร์ชันใหม่

ตัวอย่าง Skill

โครงสร้างตัวอย่างที่ดัดแปลงจากต้นฉบับ

---
name: secure-api-review
description: ใช้เมื่อต้องสร้าง แก้ไข หรือ Review External API
---
# Secure API Review
1. ทุก endpoint ต้องผ่าน Authentication ที่องค์กรกำหนด
2. Validate request ตาม schema และปฏิเสธ field ที่ไม่รู้จัก
3. Endpoint ที่เปลี่ยน state ต้องสร้าง audit event
4. ข้อมูล PII ห้ามปรากฏใน log หรือ error
5. รัน security check และแนบผลในสรุปงาน

Skill ไม่ใช่ Enforcement แบบแข็ง

Skill เป็น Advisory Control ช่วยให้ Agent ทำตาม Policy ตั้งแต่ตอนสร้างงาน แต่หาก Policy ต้องห้ามละเมิดจริง ๆ ต้องมี Deterministic Control ซ้อน เช่น Hook ที่ Block Action หรือ Review Pass ที่ตรวจซ้ำใน PR Skill ลดโอกาสผิด ส่วน Hook ทำให้การฝ่าฝืนยากขึ้นมาก

วัดผลอย่างไร

Leading indicator เวลาตั้งแต่ Policy Owner อนุมัติ Policy ใหม่จน Skill เวอร์ชันใหม่ Merge
Lagging indicator จำนวน PR Finding ที่อ้าง Policy เดิม หากไม่ลดลงต้องตรวจว่า Skill ไม่ Trigger หรือเนื้อหา Drift จาก Source of Truth

แหล่งอ้างอิงบทนี้: Skills as institutional knowledge

Stage 3 · BuildLESSON 07

Parallel sessions and subagents

เพิ่มจำนวนงานที่เดินพร้อมกันโดยแยก Working Copy และแยก Context ของ Helper ให้ชัด

Parallel Session คือ Claude Code อีก Instance ที่ทำงานคนละ Task ใน Git Worktree แยกกัน แต่ละ Session ไม่รู้บริบทของอีก Session ส่วน Subagent อยู่ภายใน Session เดียว ทำหน้าที่เฉพาะด้านด้วย Context และ Tool Limit ของตัวเอง เช่น Verifier Researcher หรือ Code Simplifier

Traditional SDLC AI-Native SDLC
Engineer ทำงานทีละเรื่องและเสียเวลาไปกับ Build Test หรือรอ Review การสลับงานบ่อยมีต้นทุนทางสมาธิสูง Engineer คุมหลาย Session พร้อมกัน งานซ้ำถูกแพ็กเป็น Subagent หน้าที่ของ Engineer ขยับไปสู่การ Steering และ Review

แนวทางใช้งาน

  1. แยก Task ให้แต่ละ Stream แตะคนละไฟล์ หากชนไฟล์เดียวกันควรทำใน Session เดียวตามลำดับ

  2. สร้าง Worktree แยกให้แต่ละงาน

  3. เริ่มจาก 2-3 Sessions ก่อน เพดานจริงคือจำนวน Stream ที่คนยัง Review ได้อย่างมีคุณภาพ

  4. เปลี่ยนงานซ้ำให้เป็น Subagent และ Commit Definition ลง Git

ตัวอย่าง verifier.md ที่เรียบเรียงจากแนวคิดต้นฉบับ

---
name: verifier
description: ตรวจว่าการเปลี่ยนแปลงทำงานจริงก่อน Session รายงานว่าเสร็จ
tools: Bash, Read
---
Start application and exercise the changed behavior.
Check two nearby flows that may be affected.
Compare what you observe with plan.md.
Report only. Do not modify the code.

Governance และ Metrics

เมื่อจำนวน Session เพิ่ม Output ก็เพิ่มตาม Controls จึงต้องอยู่ใน Repo เช่น Hooks และ Permission ที่ทุก Session ใช้เหมือนกัน กิจกรรมของ Session ต้องมี Trace และผูกกับ Engineer ที่เป็นผู้เรียกใช้งาน

Leading indicator จำนวน Concurrent Sessions ต่อ Engineer ในจุดที่ Review Quality ยังไม่ตก และสัดส่วนเวลาที่ใช้ Steering แทนการรอ
Lagging indicator จำนวน Change ที่ Merge ต่อ Engineer ต่อสัปดาห์ โดยต้องอ่านคู่กับ Rework Rate

แหล่งอ้างอิงบทนี้: Parallel sessions and subagents

Stage 4 · TestLESSON 08

Give Claude a feedback loop

อย่าให้ Agent ส่งงานก่อนมีวิธีตรวจงานของตัวเอง

Feedback Loop คือกลไกที่ทำให้ Agent เห็นผลของงานระหว่าง Task ไม่ใช่รอให้ CI หรือ Tester มาบอกทีหลัง วิธีตรวจอาจเป็น Unit Test Build Lint Screenshot Diff หรือการเรียก API แล้วตรวจ Response เมื่อสัญญาณกลับมาเร็ว Agent สามารถแก้ข้อผิดพลาดเองก่อนส่งให้คน

Traditional SDLC AI-Native SDLC
สัญญาณว่า Code ใช้ได้มาถึงช้า CI อาจมาในอีกหลายนาที QA อาจตรวจอีกหลายวัน ทำให้คนกลายเป็นคอขวด Session มีวิธี Verify ระหว่างทำงาน Agent ทำซ้ำจน Check ผ่านก่อนให้ Engineer เห็น

สร้าง Feedback Loop ที่ดี

  1. รวมขั้นตรวจหลายคำสั่งให้เหลือ Target เดียวที่ Exit non-zero เมื่อ Fail

  2. บันทึกคำสั่งและตัวอย่างผลลัพธ์ที่ดีไว้ใน CLAUDE.md

  3. ตั้ง Target ที่วัดได้ เช่น Tests ชุดใดต้องผ่าน หรือ Screenshot ต้องตรง Mock

  4. Bug Fix ควรเริ่มจาก Failing Test แล้วห้าม Agent แก้ Test เพื่อทำให้ตัวเองผ่าน

  5. งาน UI ให้ Agent Implement → Screenshot → Compare → Adjust หลายรอบ

  6. นิยาม Verification เป็นส่วนหนึ่งของ Done และให้แนบผล Tool Output

  7. ปกป้องตัวตรวจเอง เช่น Hook ห้ามแก้ Test ระหว่าง Fix

Verification Block สำหรับ CLAUDE.md

## Verifying your work
- Build: dotnet build # ต้องสำเร็จ
- Test: dotnet test # ต้องผ่านทุก Test ที่เกี่ยวข้อง
- Lint: dotnet format --verify-no-changes
Run all checks before reporting completion.
If a test fails, fix the code. Do not weaken the test.

แหล่งอ้างอิงบทนี้: Give Claude a feedback loop

Stage 4 · TestLESSON 09

Continuous evals in CI

ทดสอบไม่ใช่แค่ Code แต่ทดสอบ Configuration ที่กำกับ Agent ด้วย

Eval คือ Regression Test ของพฤติกรรม Agent หากเปลี่ยน Model Prompt CLAUDE.md Skill หรือ Hook แล้ว Agent ยังทำงานได้มาตรฐานเดิมหรือไม่ต้องพิสูจน์ด้วย Suite ที่รันซ้ำได้ Playbook แนะนำให้เริ่มจากงานจริงประมาณ 20-50 งาน พร้อม Expected Outcome หรือ Acceptance Check ที่ชัดเจน

Workflow

  1. เก็บงานจริงล่าสุดพร้อมผลลัพธ์ที่ทีมยอมรับ

  2. เขียนแต่ละงานเป็น Prompt + Checks เช่น Test ผ่าน Lint สะอาด Behavior ไม่เปลี่ยน Policy ไม่ถูกละเมิด

  3. รัน Suite แบบ non-interactive ใน CI ตาม Schedule และเมื่อ Agent Configuration เปลี่ยน

  4. Gate การ Merge หาก Pass Rate ลดลง

  5. ทุก Production Incident ควรถูกเพิ่มเป็น Regression Eval ถาวร

ตัวอย่าง CI Workflow ที่ย่อและปรับจากต้นฉบับ

name: Agent Evals
on:
pull_request:
paths: ['CLAUDE.md', '.claude/**']
schedule:
- cron: '0 2 * * *'
jobs:
evals:
runs-on: ubuntu-latest
steps:
- uses: actions/checkout@v4
- name: Run eval suite
run: ./evals/run-all.sh

Governance

Evals ทำหน้าที่เป็น QA Gate ที่ทันกับ Output ของ Agent Pass-rate Threshold ถูกใช้เป็น Merge Check และผลลัพธ์แต่ละครั้งต้องเก็บ Log เพื่อเทียบย้อนหลัง ทีมเจ้าของ Configuration เป็นผู้อนุมัติการเปลี่ยนที่มีผลต่อพฤติกรรม Agent

วัดผลอย่างไร

Leading indicator Eval Pass Rate ตามเวลา และเวลาที่ใช้เปลี่ยน Production Incident ให้เป็น Eval ถาวร
Lagging indicator จำนวน Regression ที่จับได้ใน CI เทียบกับ Regression ที่หลุดไป Production

แหล่งอ้างอิงบทนี้: Continuous evals in CI

Stage 5 · DeployLESSON 10

AI in the PR review loop

ให้ Agent ช่วย Review และรับ Review Comment เพื่อย้ายเวลาของคนไปอยู่ที่ Intent และ

Claude สามารถทำได้ทั้งสองด้านของ PR Loop คือ Review PR ตาม Policy ขององค์กร และแก้ Comment ใน PR ของตัวเอง จุดหมายไม่ใช่เอาคนออกจาก Approval แต่ทำให้ทุก PR ได้ Review Pass มาตรฐานเดียวกัน แล้วให้มนุษย์ใช้เวลาไปกับการตัดสินใจระดับสูงกว่า

Traditional SDLC AI-Native SDLC
PR รอ Reviewer อ่านทุกบรรทัด คุณภาพ Review แปรตามภาระงาน และ Backlog โตเมื่อ Output เพิ่ม ทุก PR ผ่าน Review Pass แบบเดียวกัน Finding ถูกจัด Severity คนโฟกัสว่า Change ตรง Intent หรือไม่และ Risk ยอมรับได้หรือไม่

REVIEW.md เป็น Policy ของ Reviewer

ตัวอย่าง REVIEW.md ที่ดัดแปลงจากต้นฉบับ

# Review instructions
## Passes
- Bugs: logic errors, edge cases, regressions
- Security: injection, auth gaps, sensitive data in logs
- Compliance: เทียบกับ spec.md, plan.md และ design principles
## Severity
Important = เสี่ยงพังข้อมูล รั่วข้อมูล หรือผิด Policy
Nit = style หรือ naming ที่ไม่กระทบ Behavior
## Noise control
จำกัด Nit ต่อ Review และไม่รายงาน Generated Files หรือสิ่งที่ CI ตรวจอยู่แล้ว

Review-Fix Loop

  1. Tech Lead กำหนด Review Pass และ Severity

  2. Branch Protection ยังคงต้องใช้ Code Owner Approval

  3. เมื่อมี Comment ที่ Tag @claude Agent แก้และ Push Update กลับเข้า PR

  4. สามารถทำ Slash Command เพื่อไล่ Comment ที่ยังไม่ Resolve และ Check ที่ Fail จน PR Green

  5. หาก Review พบความผิดเดิมซ้ำ ให้ Feedback กลับเข้า CLAUDE.md

Governance และ Metrics

Separation of Duties ยังอยู่ครบ Agent ที่เขียน Code ไม่สามารถอนุมัติ Code ของตัวเองได้ PR History เก็บ Finding Fix Rating และ Approval จึงทำหน้าที่เป็น Audit Record

Leading indicator Time to First Review และสัดส่วน Review Comment ที่ Agent แก้จนจบโดยไม่ต้องให้คนแตะ Branch
Lagging indicator Defect และ Vulnerability ที่จับได้ก่อน Merge เทียบกับสิ่งที่หลุดไป Production

แหล่งอ้างอิงบทนี้: AI in the PR review loop

Stage 5 · DeployLESSON 11

Hooks as approval gates

เปลี่ยน Approval Policy ให้เป็น Gate ที่ทำงานทุกครั้งเมื่อ Agent กำลังจะทำ Action

Hook ไม่ได้มีไว้ Block อย่างเดียว แต่สามารถ Allow Ask หรือ Block ได้ จึงใช้เป็น Release Gate ที่หยุด Action จนผู้มีสิทธิ์อนุมัติ เหมาะกับ Production Deploy Change Management Sign-off การแก้ Migration หรือ Protected Path รวมถึงการห้ามแก้ Test File ระหว่าง Bug Fix

จาก Policy สู่ Hook

  1. รวบรวม Human Approval Gate ที่องค์กรต้องรักษาไว้

  2. แปลง Gate เป็น Script ที่รันก่อน Agent Action

  3. Team Hook เก็บใน .claude/settings.json ส่วนกฎที่ห้าม Override ควรอยู่ใน Managed Settings

  4. เมื่อ Block ต้องอธิบายเหตุผลและเส้นทางขออนุมัติให้ชัด

.claude/settings.json — โครงสร้างตัวอย่าง

production-gate.sh — ตัวอย่าง Gate ที่ย่อจากแนวคิดต้นฉบับ

Managed Settings สำหรับองค์กรที่ต้องคุมเข้ม

Playbook เสนอการควบคุมหลายชั้น เช่น Deny การอ่าน Secret และ Network Egress อนุญาตเฉพาะคำสั่ง Build/Test/Lint เปิด Sandbox แบบ Fail-closed จำกัด Credential บังคับเฉพาะ Managed Hooks จำกัด MCP Server และ Plugin Marketplace และกำหนด Minimum Version แนวคิดสำคัญคือ Control สำคัญต้องอยู่ในระดับที่ Engineer รายบุคคลไม่สามารถปิดหรือขยายสิทธิ์ได้เอง

วัดผลอย่างไร

Leading indicator เวลารอแต่ละ Approval Gate จาก Timestamp ของ Hook Decision
Lagging indicator จำนวน Gate Violation ที่ยังหลุดถึง Production ก่อนและหลังใช้ Hook

แหล่งอ้างอิงบทนี้: Hooks as approval gates

Stage 5 · DeployLESSON 12

CI/CD integration and deployment

ให้ Claude ทำงานแบบ non-interactive ใน Pipeline ภายใต้ Sandbox Credential

Traditional SDLC AI-Native SDLC
Pipeline รัน Script แบบ Deterministic แต่เมื่อเกิดงานที่ต้องใช้ Judgment ต้องรอคน เช่นวิเคราะห์ Build Fail หรือ Flaky Test Claude ทำ Judgment Step ใน Pipeline ได้แบบ non-interactive และทำงานใน Sandbox ด้วย Scoped Credential การ Deploy/Rollback ถูกเปิดเป็น Tool ผ่าน MCP

แนวทางค่อย ๆ เพิ่ม Autonomy

  1. เริ่มจาก Read-only Judgment เช่นสรุป Build Fail หรือ Flaky Test

  2. เพิ่ม Write Step หลัง Gate เช่นแก้ Lint หรืออัปเดต Generated Docs โดยผลต้องกลับมาเป็น PR

  3. Sandbox ทุก Agent Job และใช้ Token แบบ Short-lived

  4. เปิด Deploy Status Rollback ผ่าน MCP แบบ Allowlist ต่อ Environment

  5. Dev ให้อิสระมากกว่า Staging และ Production ส่วน Production ต้องมี Release Manager Gate

  6. ซ้อม Rollback ให้เป็นเส้นทางที่เชื่อถือได้ที่สุดก่อนมอบให้ Agent เรียก

Pipeline Step ตัวอย่างที่ดัดแปลงจากต้นฉบับ

วัดผลอย่างไร

Leading indicator สัดส่วน Pipeline Failure ที่ Agent วิเคราะห์ได้โดยไม่ต้อง Page คน
Lagging indicator DORA Metrics จากระบบ CI/CD และ Deployment เช่น Lead Time Change Failure Rate และ Recovery

แหล่งอ้างอิงบทนี้: CI/CD integration and deployment

Stage 6 · MaintainLESSON 13

Closing the loop on metrics

ให้ Trigger จาก Production เริ่มวงจรใหม่โดยไม่ต้องรอคนเป็นผู้กดเริ่มทุกครั้ง

Stage 6 คือจุดที่ AI-Native SDLC เริ่มทำงานเป็น Loop จริง ๆ Trigger อาจมาจาก Metric ที่หลุด Control Band Ticket ข้อความในช่อง Incident หรือ Schedule จากนั้น Agent วิเคราะห์ปัญหาและเขียนผลเป็น intent.md เพื่อส่งกลับเข้ากระบวนการ Plan → Design → Build → Test → Review อีกครั้ง

Traditional SDLC AI-Native SDLC
Maintenance เป็นงาน Reactive Alert หรือ Ticket ต้องรอคนหยิบขึ้นมา Post-mortem Action อาจไม่กลับถึง Codebase Trigger เรียก Agent ได้โดยตรง Agent Diagnose ผ่านสิทธิ์ที่กำหนด และเขียน intent.md เพื่อเข้าสู่ Pipeline เดิม คนยังทำหน้าที่ Triage และ Review

Deterministic Detection ก่อน Agent Reasoning

Playbook แยกหน้าที่ชัดเจน Detection ควรเป็น Script ที่วัดได้และ Unit Test ได้ ไม่ใช้ Model ตัดสินว่ามี Incident หรือไม่ จากนั้นเมื่อ Metric หลุด Band จึงค่อยเรียก Agent ตาม Tier เพื่อ Diagnose หรือ Propose Action

bands.yaml — ตัวอย่าง Response Tier ที่ดัดแปลงจากต้นฉบับ

Workflow

  1. เลือก Metric ที่มี Rolling Baseline เสถียร เช่น CI Failure Rate 5xx หลัง Deploy หรือ PR Cycle Time

  2. เขียน Detection Script และเก็บใน Version Control

  3. กำหนด Tier เช่น 1σ Log 2σ Diagnose แบบ Read-only และ 3σ Propose Action ผ่าน Route ที่อนุมัติ

  4. Trigger ผ่าน Scheduled Workflow Webhook หรือ Cron แล้วรัน Agent แบบ Stateless

  5. Agent เขียน Diagnosis เป็น intent.md

  6. Service Owner หรือ On-call Triage ว่าจะแก้ทันที วางแผน หรือ Dismiss

  7. เมื่อ Fix แล้วเพิ่ม Incident นี้เป็น Eval เพื่อไม่ให้ปัญหาเดิมกลับมา

ตัวอย่างการปิด Loop

  • CI Test Failure สูงผิดปกติ: Agent อาจเสนอ Quarantine Flaky Test หรือเปิด Revert PR แล้วให้ Review Gate ตัดสิน

  • 5xx หลัง Deploy พุ่ง: Agent เรียก Rollback Pipeline ที่ซ้อมไว้แล้ว

  • PR Cycle Time Drift: Agent สร้าง Report ให้ Engineering Leadership เพื่อชี้ว่าคอขวดอยู่ที่ Process ไม่ใช่ Production

Claude Tag และงานที่เข้าจากช่องสื่อสาร

ต้นฉบับยก Claude Tag ใน Slack เป็นอีกช่องทางหนึ่งสำหรับ Incident หรือ Ticket Agent สามารถเป็น First Responder ภายใต้ Identity ของตนเอง ตรวจสมมติฐานผ่าน MCP และเปลี่ยนงานขนาดใหญ่ให้เป็น intent.md ส่วนงานเล็กและ Bound ชัดสามารถส่งเป็น PR ผ่าน Review Gate ได้ แนวคิดสำคัญไม่ใช่ตัวช่องทาง แต่คือการทำให้งานที่เข้ามาไหลกลับเข้าสู่ Artifact Chain เดิม

วัดผลอย่างไร

Leading indicator เวลาจาก Control Band Breach ถึง intent.md เข้าคิว Triage
Lagging indicator สัดส่วน Finding ที่กลายเป็น Merged Fix และจำนวน Incident ประเภทเดิมที่เกิดซ้ำ ซึ่งควรลดลงเมื่อถูกเพิ่มเข้า Eval Suite

แหล่งอ้างอิงบทนี้: Closing the loop on metrics

บทส่งท้ายLESSON 14

Closing thoughts and resources

AI-Native SDLC คือการย้าย Human Attention ไปยังจุดที่ต้องใช้ Judgment พร้อมทำให้

เมื่อ Model และ Agent Harness มีความสามารถมากขึ้น สิ่งที่องค์กรปรับได้ไม่ใช่เพียงวิธีผลิต Code แต่คือ Software Development Lifecycle ทั้งวงจร จุดยืนของ Playbook คือ Human Judgment ยังต้องอยู่กลางระบบ โดยเฉพาะการตัดสินใจที่มี Risk หรือข้อกำกับสูง เพียงแต่คนไม่จำเป็นต้องเป็นผู้เริ่มและทำงานเชิงกลทุกขั้นอีกต่อไป

ภาพสรุป Artifact Chain ของวงจร AI-Native SDLC

Resource ที่ทีม Platform ควรศึกษา

  • การตั้งค่า Claude Code สำหรับองค์กรและ Decision Map ของ Admin

  • Settings Reference และ Server-managed Settings

  • Permissions และ Sandboxing ระดับ OS

  • Hooks Guide และ Hooks Reference

  • Skills รวมถึง Plugins และ Private Marketplace

  • Managed MCP เพื่อควบคุม Tool Surface จากส่วนกลาง

  • Enterprise Deployment ผ่าน Amazon Bedrock, Vertex AI หรือ Microsoft Foundry

  • Enterprise Network Configuration

  • OpenTelemetry Monitoring และ Analytics Dashboard

  • Compliance API

  • Security Model ของ Claude Code

แหล่งอ้างอิงบทนี้: Closing thoughts and resources

สรุป Playbook ในหน้าเดียว

Stage Artifact สิ่งที่เปลี่ยน Human Gate
Plan intent.md จับปัญหาและเจตนาจากเจ้าของเรื่องหรือ Trigger Product Owner
Design spec.md แปลง Intent เป็น Requirement/Design ภายใต้ Skills Product Owner + Policy Owner
Build plan.md + Code Plan ก่อนแก้ Code ใช้ CLAUDE.md Skills Worktrees Subagents Engineer / Tech Lead
Test Evidence + Evals Feedback Loop ระหว่างทำงาน และ Regression Eval ใน CI Engineer + QA/Platform
Deploy PR + Logs Agent Review Hooks Approval Gate และ CI/CD แบบ Sandbox Code Owner + Release Manager
Maintain Incident + intent.md Metric/Incident Trigger Diagnosis และวนกลับเข้า Plan Service Owner / On-call

แหล่งอ้างอิงทั้ง 14 บท

1. Introduction

2. Capture as intent.md

3. Requirements and design

4. Claude Code plan mode as the default starting point

5. The CLAUDE.md

6. Skills as institutional knowledge

7. Parallel sessions and subagents

8. Give Claude a feedback loop

9. Continuous evals in CI

10. AI in the PR review loop

11. Hooks as approval gates

12. CI/CD integration and deployment

13. Closing the loop on metrics

14. Closing thoughts and resources

© 2026 Anthropic PBC สำหรับเนื้อหาต้นฉบับ · หนังสือฉบับนี้เป็นการเรียบเรียงภาษาไทยเพื่อการศึกษาและอ้างอิงแนวคิด